英伟达开源语音转录模型 Nemotron 3.5 Transcribe:40 种语言,八人抢话也精准
英伟达在 10 月 28 日对外发布了一款开放权重语音转录模型 Nemotron 3.5 Transcribe,并一并公开了名为 Granary v2 的训练数据管线。据 IT之家 10 月 29 日消息,该项发布由英伟达于昨日正式披露。
Nemotron 3.5 Transcribe 将转录、说话人归属、翻译以及音频问答等功能融为一体,其目标场景涵盖会议纪要生成、课堂录像整理、访谈内容归档以及多语种客服等。
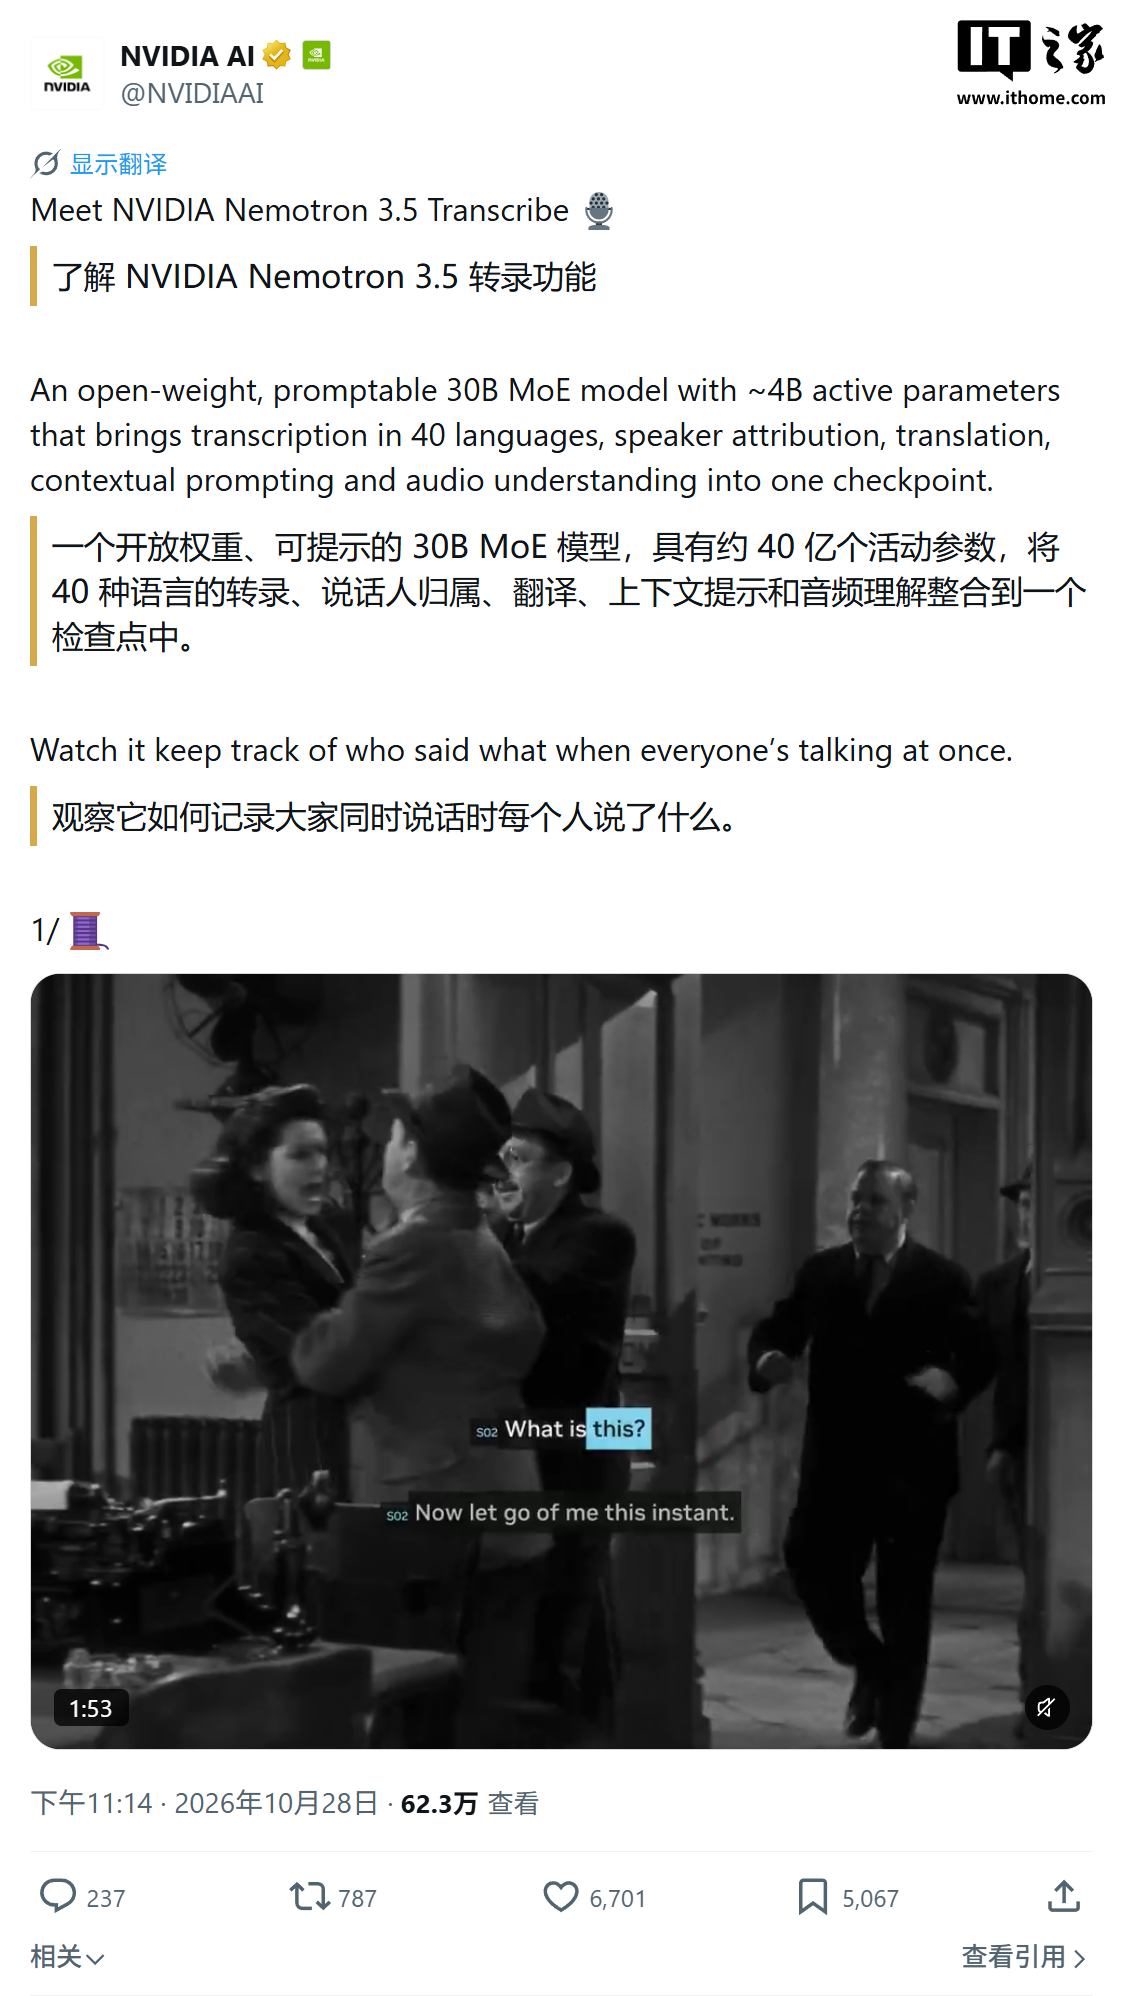
从技术规格看,该模型选用混合专家(MoE)架构,参数总量约为 340 亿,而在推理时实际激活的参数约为 43 亿。它能够一次性处理最长达 1 小时的录音素材,转录语种覆盖 40 种,其中 31 种可与英语互译;就说话人识别而言,最多可区分 8 位发言者,并支持对其中 13 种语言标注说话人身份。
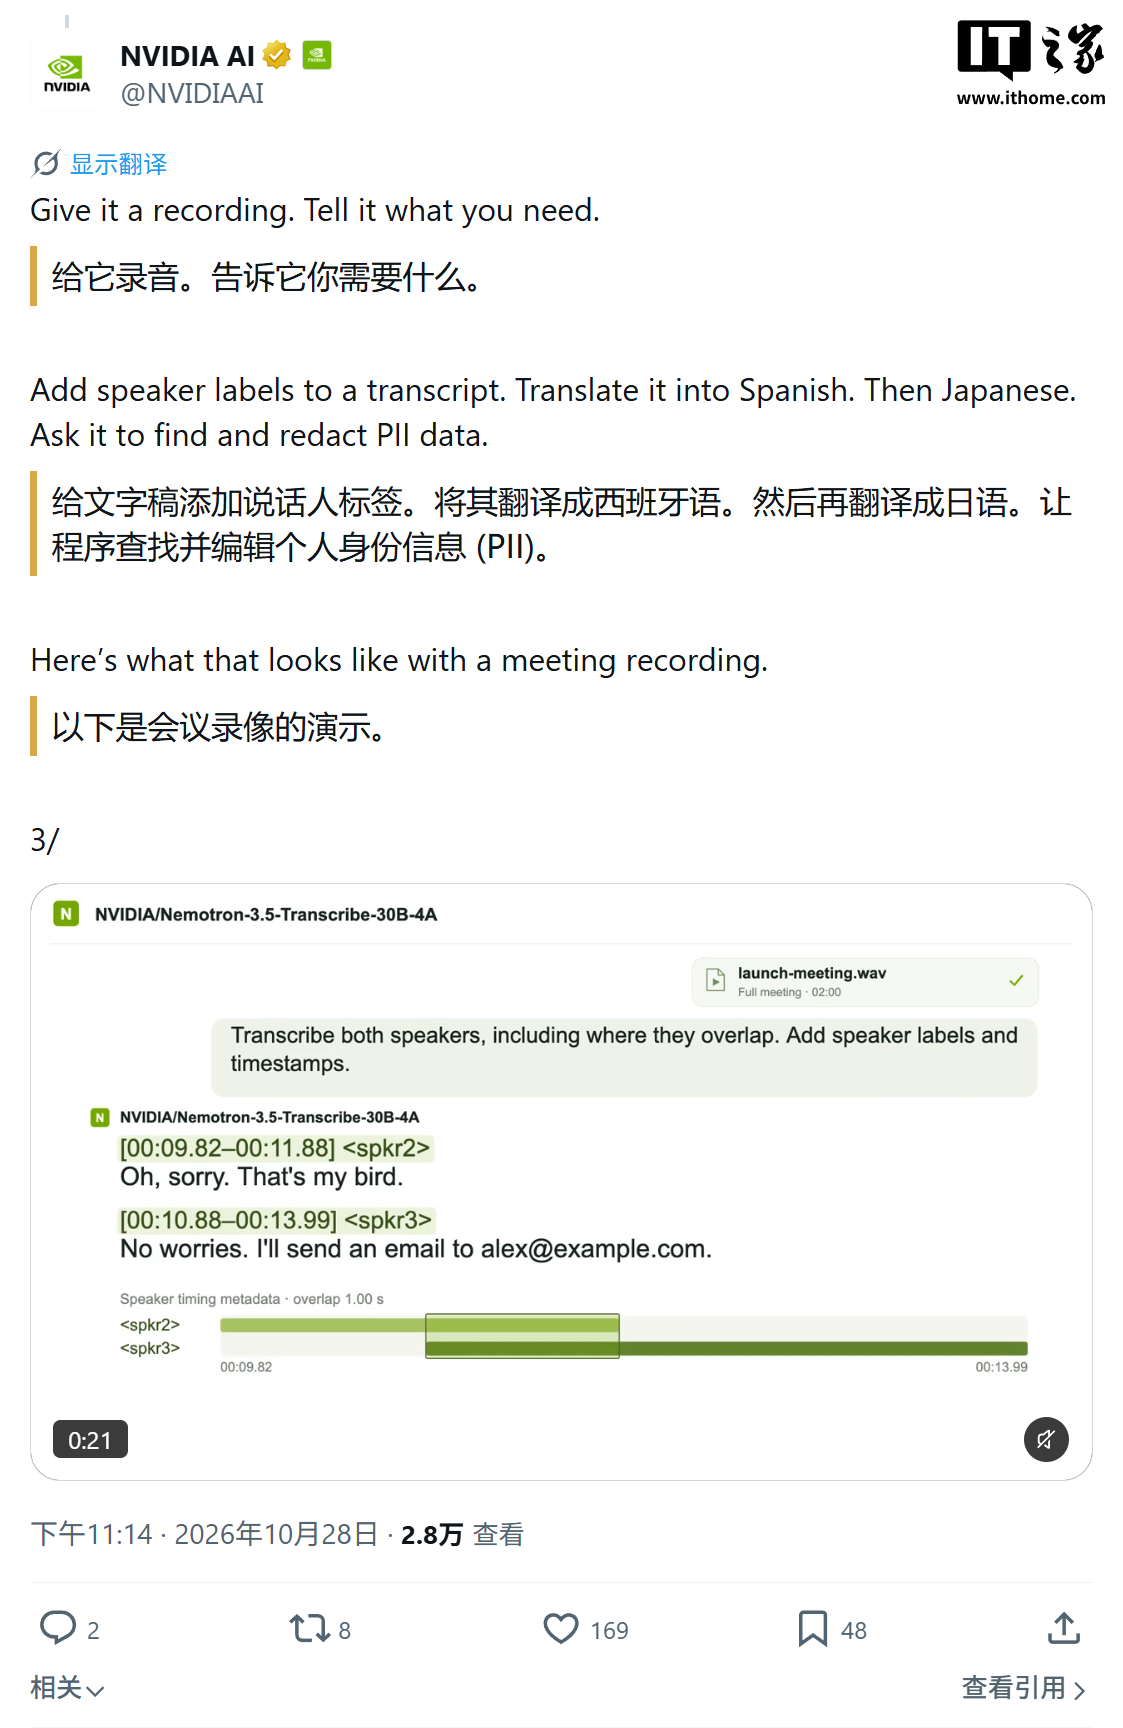
这款模型最突出的优势,在于应对多人同时发言的复杂场景。它在输出文本的同时,就能为每一段话标注对应的说话人。英伟达在演示环节展示了 1940 年影片《他的女友礼拜五》的片段——片中语速飞快且对白大量重叠,模型依然能够分角色生成字幕。
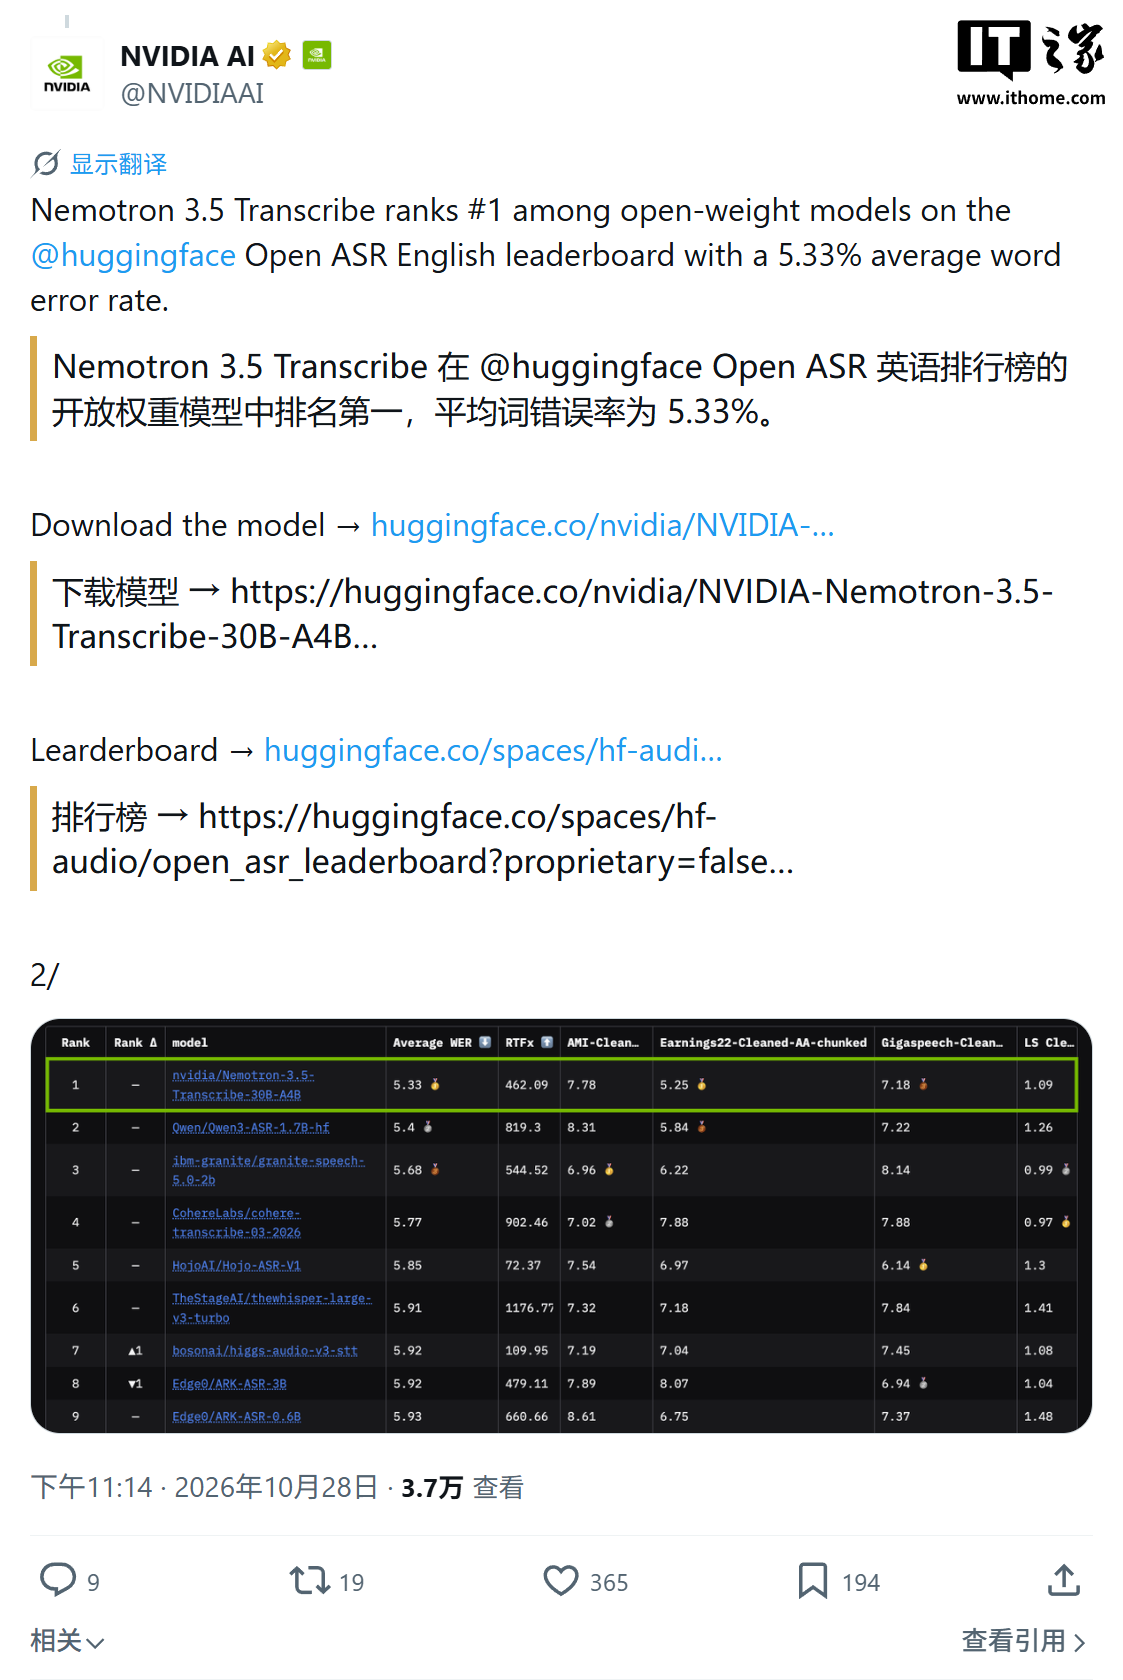
在公开评测榜单上,该模型于 Hugging Face 的 Open ASR Leaderboard 英语分区,以 5.33% 的平均词错误率,排在全部开放权重模型的第一位。
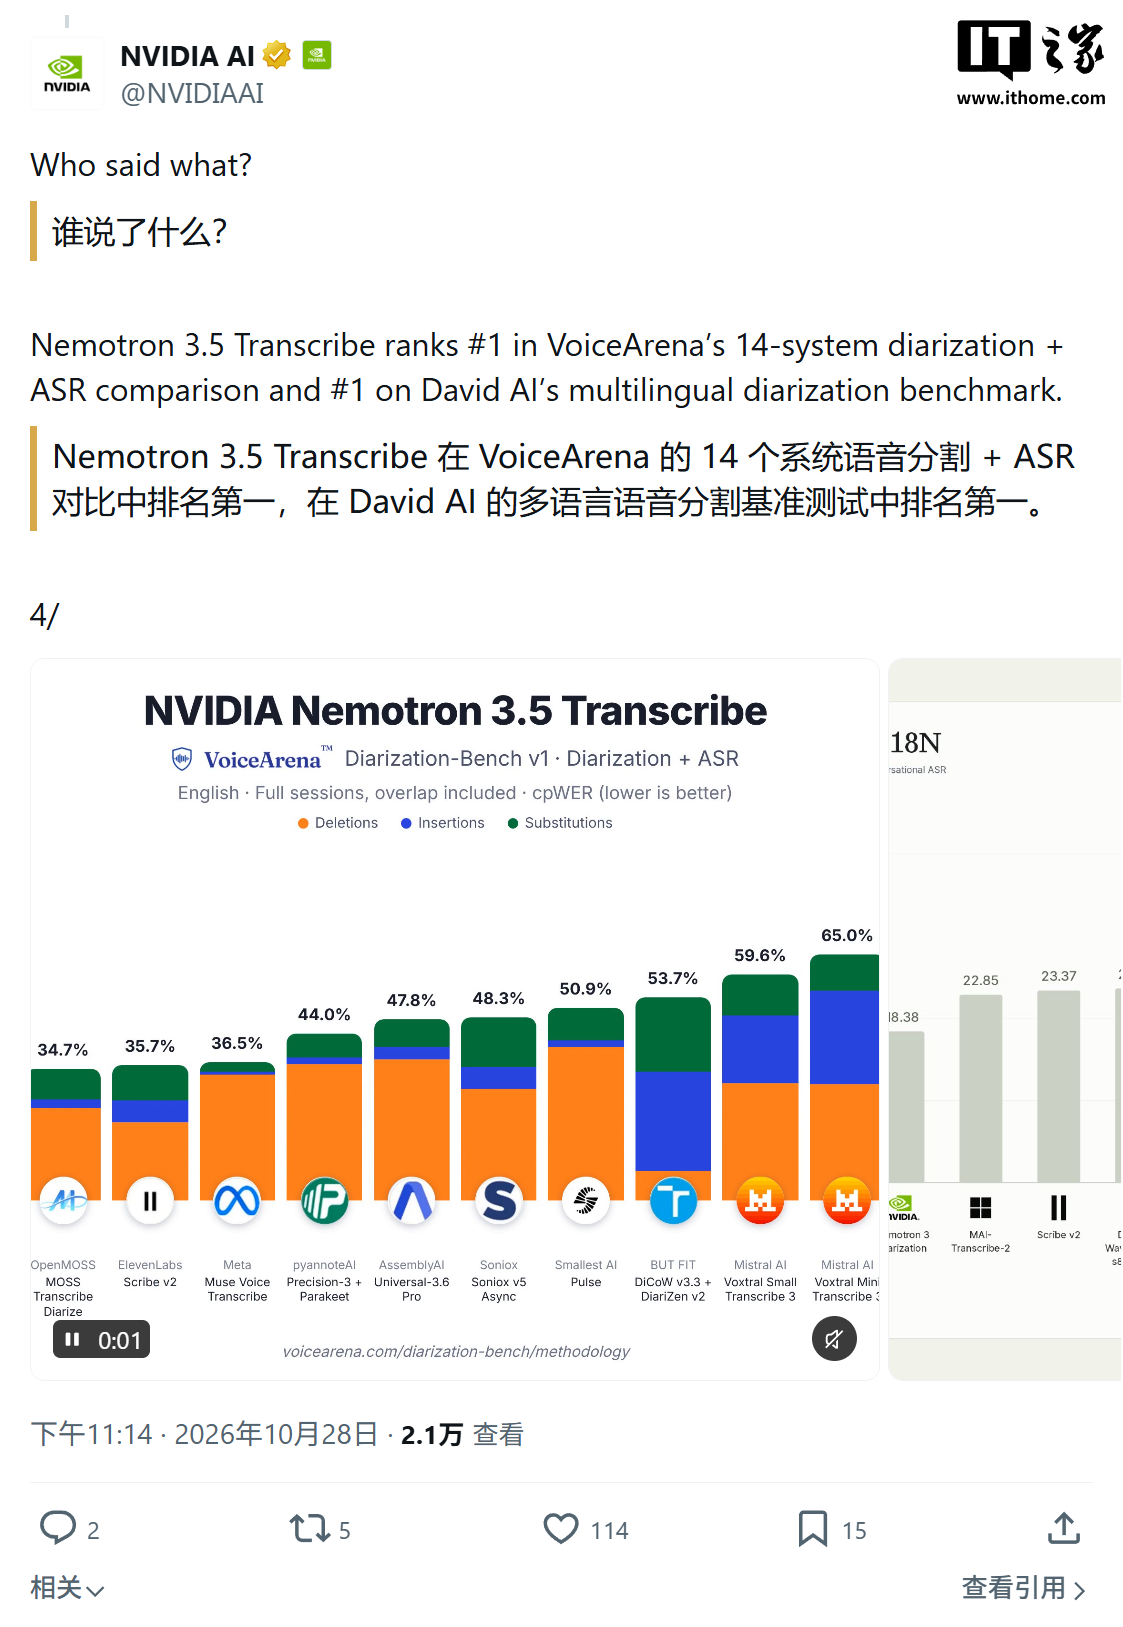
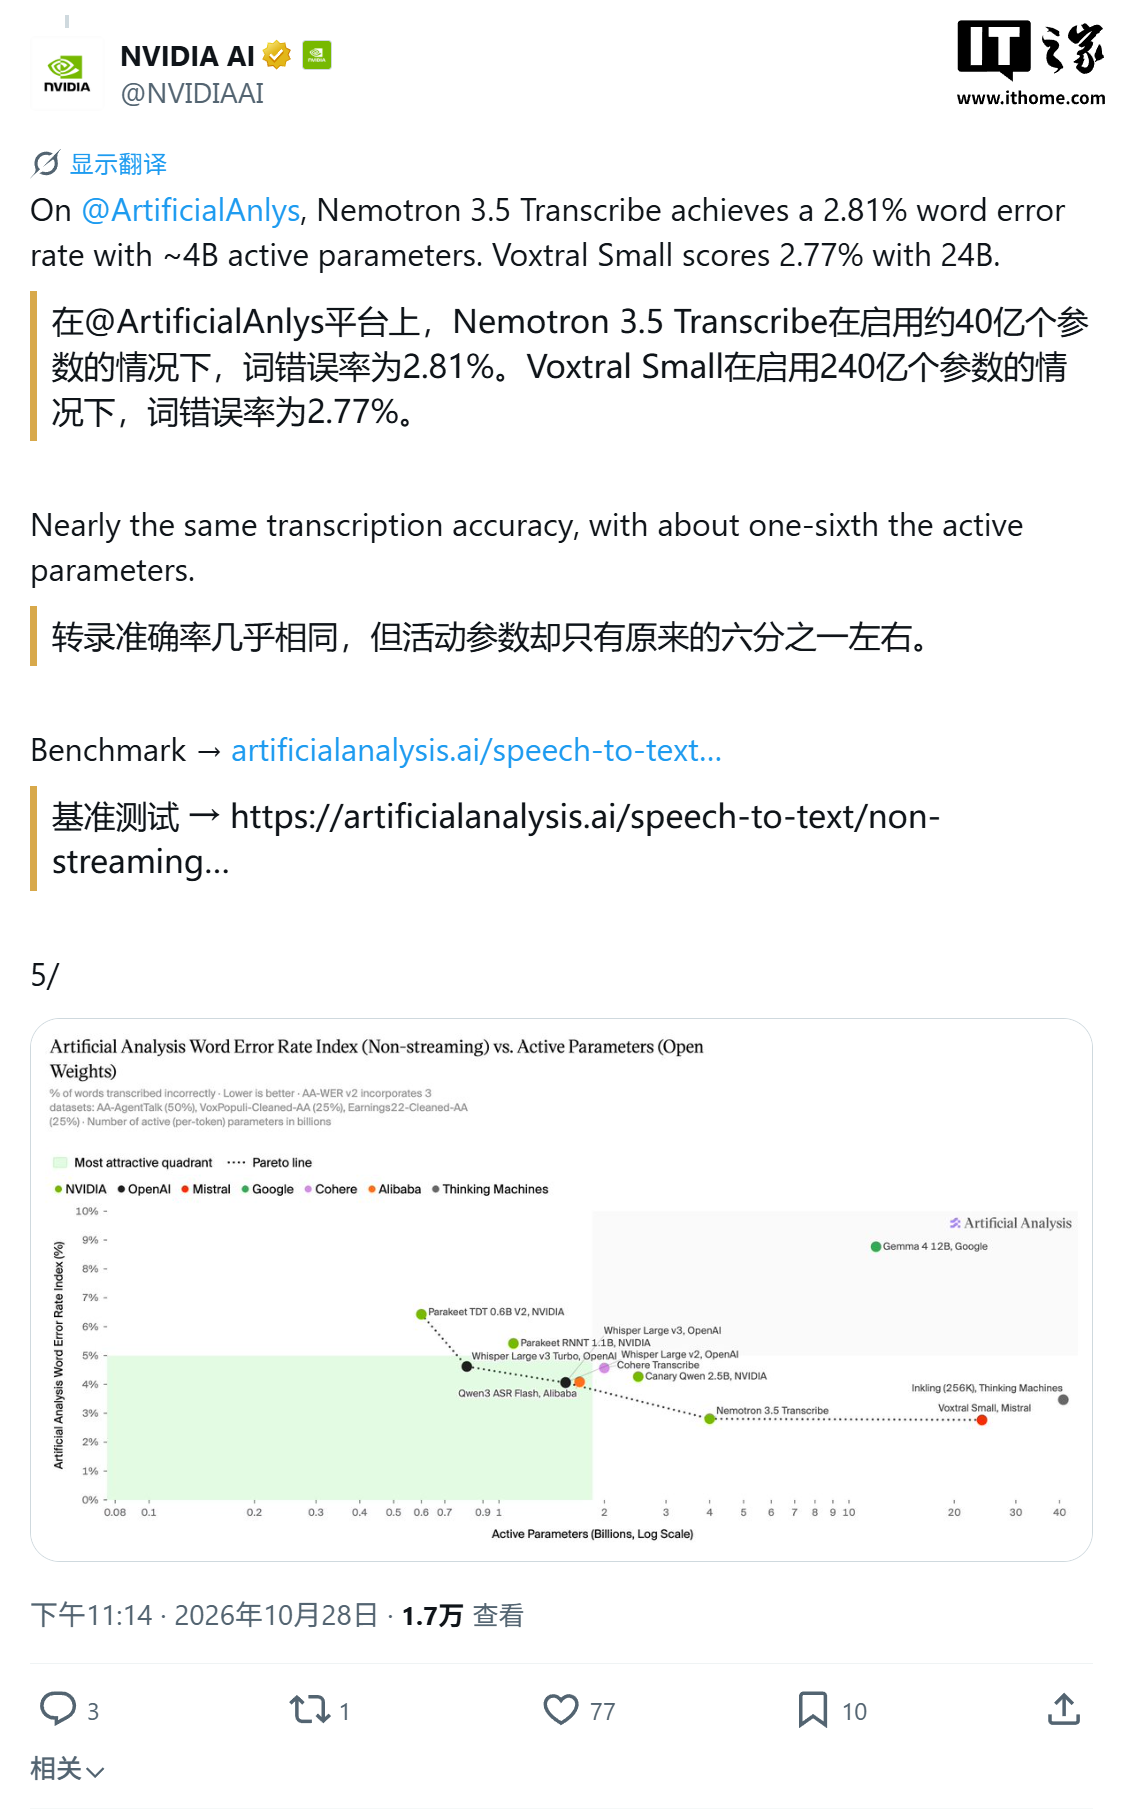
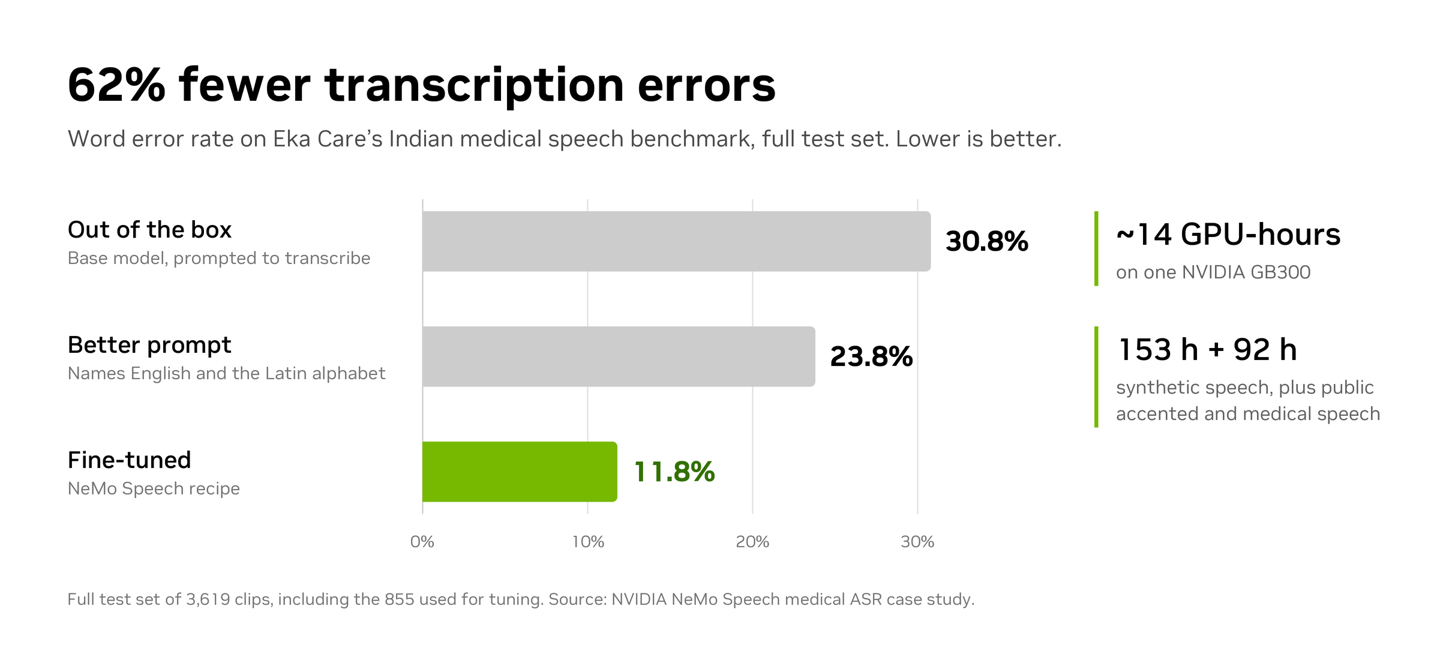
Artificial Analysis 发布的不含流式处理(非流式)词错误率指标中,它取得 2.8% 的成绩,与 Voxtral Small Transcribe 并列为开源模型中的最佳。至于说话人归属能力,它在 David AI 面向 21 种语言的说话人分离基准里,创下了 18.26% 的最低错误率。相关截图如下所示:
目前该模型已在 Hugging Face 与 ModelScope 两个平台免费提供,授权协议采用 OpenMDW-1.1;官方表示后续还会推出量化版本,以便模型能在 RTX Spark、DGX Spark、Jetson AGX Thor 这类本地设备上流畅运行。
Granary v2 是 NVIDIA 面向多语种语音模型(Nemotron 3.5 Transcribe 即为其一)打造的一套开放、可复用的训练数据加工管线与数据集。
它能够把原始音频或已有标注的音频,自动转换为多种转录格式,并衍生出翻译、字幕、问答与指令对,用于支撑 ASR、语音翻译以及语音指令的微调工作。
公开资料显示,Granary v2 的数据清单包含 463,062 小时音频、覆盖 48 种语言、汇集自 16 个源语料库,相较 Granary v1 仅有的 25 种语言有了明显拓宽。
针对同一段录音,Granary v2 至少会生成三种不同转录变体,以适配模型在被提示时可能要求的多种书面风格:
- 文本规范化逐字稿(tn_raw):保留“呃”“嗯”这类不流畅表达,但对数字等文本做规范化处理,例如 “I paid, uh, twenty-five euros.”
- 逆文本规范化、含不流畅表达(itn_raw):将口语化的数字还原成书面符号,如 “I paid, uh, €25.”
- 逆文本规范化、去除不流畅表达(itn_clean):输出整洁易读的文本,如 “I paid €25.”
本文内容整理自公开网络资讯,仅供参考,版权归原作者所有。
相关文章
- 复盘分享:「高性价比人生指南」衍生网站,一周 8k+ 用户
- Deno 的八年:一场没逃出 Node 引力的运行时起义
- 20 个平台热榜:8 个有接口,一次静默失败 12 天
- 我们为什么又做了一个文件压缩工具?
- 把 NAS 设为 UPS 总控,实现局域网设备断电有序关机
- 实战记录:如何申请解除 iPhone 激活锁及避坑要点
- 人工智能冲击初级编程岗,美国高校计算机专业招生明显遇冷
- 英伟达开源语音转录模型 Nemotron 3.5 Transcribe:40 种语言,八人抢话也精准
- 【源码分享】星光岛AI v3.0.2 - AI工具导航+提示词库+资讯教程一体化站点程序
- AI综合站商业分发系统v3.1纯净版发布 附完整安装教程(排版修正版)